AI & data
Data bruikbaar maken met AI
Drie praktijkvoorbeelden uit legal AI-onderzoek en een CRM-migratie
Een klantendatabase kan jaren aan communicatie bevatten en toch geen antwoord geven op een eenvoudige vraag: in welke sectoren zijn klanten actief? Het antwoord staat misschien ergens in een e-mail, een korte bedrijfsomschrijving of op een website. Maar zolang niemand die informatie omzet in een bruikbaar veld, kun je er niet over rapporteren.
Die kloof kom ik tegen in zowel onderzoek als projecten voor opdrachtgevers: de informatie is in theorie aanwezig, maar niet in het gewenste formaat. Tientallen records met de hand labelen is nog te overzien, maar bij duizenden wordt het al snel een project op zichzelf, en belandt het weer op de plank. Dat werpt een praktische vraag op: hoeveel van dat werk kun je redelijkerwijs aan AI uitbesteden?
Ik heb ontdekt dat data-annotatie een van de meer bruikbare toepassingen is voor generatieve AI. Het bestaat uit het toevoegen van labels of andere informatie aan bestaande data: een categorie, een simpele boolean (ja of nee) of een korte omschrijving. Aan de hand van drie praktijkvoorbeelden uit mijn eigen werk laat ik zien wat daarmee mogelijk is, en welke keuzes nodig zijn om tot bruikbare resultaten te komen.
Onderzoek naar AI-annotatie
Voor de praktijkvoorbeelden is het zinvol om na te gaan wat uit onderzoek blijkt over de kwaliteit van AI-annotatie en hoe je die systematisch aanpakt. Törnberg (2023) vergeleek GPT-4 met crowdworkers en twee politicologen voor een specifieke taak: achterhalen of een tweet door een Republikeinse of Democratische politicus was geplaatst. Zijn steekproef bevatte 500 tweets, gelijk verdeeld over de twee partijen. De partij van de twitteraar vormde steeds het referentieantwoord, de gold standard. GPT-4 presteerde beter dan zowel de politicologen als de gecombineerde antwoorden van de crowdworkers, en gaf bovendien consistentere antwoorden.
Dat is bemoedigend, maar toont nog niet aan dat LLM’s bij allerlei annotatietaken beter presteren dan mensen. In een overzicht van twaalf onderzoeken vonden Pavlovic & Poesio (2024) veelbelovende resultaten wanneer het oordeel van de meerderheid van de menselijke beoordelaars als juiste antwoord gold. Hun eigen experimenten lieten ook een beperking zien: bij subjectieve vragen konden de modellen de diversiteit aan menselijke opvattingen niet betrouwbaar reproduceren. Eén label kan bruikbaar zijn, maar tegelijk betekenisvolle verschillen van inzicht verbergen.
In de praktijk vraagt dit om een zorgvuldige taakomschrijving en toetsing op de data waarmee je wilt werken. Törnberg (2024) stelt een systematische aanpak voor het coderen van data voor, die begint met een codeboek: een expliciete beschrijving van de categorieën en de regels om ze toe te kennen. Menselijke annotatoren en het AI-model labelen een kleine steekproef. Vervolgens worden verschillen onderzocht en de instructies aangescherpt. Zodra de prompt vaststaat, kan een aparte validatiesteekproef worden gebruikt om de prestaties te meten.
Ook het outputformaat is van belang. Met JSON, een gestructureerd tekstformaat dat computers eenvoudig kunnen lezen, en een vooraf vastgesteld outputschema zijn de antwoorden van het model gemakkelijk te valideren en te verwerken.
Ten slotte spelen bij de keuze van een model verschillende factoren mee. Törnberg (2024) noemt onder meer ethische en juridische afwegingen: waar worden de data verwerkt en worden ze gebruikt voor training? Daarnaast moet het model de taal van je data goed ondersteunen en in staat (“slim genoeg”) zijn om de complexiteit van de taak aan te kunnen (Törnberg, 2024).
Relevante jurisprudentie vinden
Voor mijn bachelorscriptie Informatica aan de Universiteit van Amsterdam heb ik de actio pauliana van artikel 42 Faillissementswet gemodelleerd. Deze bepaling stelt een curator in staat om rechtshandelingen die schuldeisers hebben benadeeld te vernietigen (Boven, 2026; Boven et al., 2026). Onderdeel van dat model is het vinden van relevante jurisprudentie op rechtspraak.nl. Om dat goed te laten werken, moest iedere uitspraak eerst worden gelabeld: oordeelt de rechter inhoudelijk over een of meer van de drie onderzochte vereisten, waarvan de toepassing juridische interpretatie vraagt?
Per vereiste gaf het model een boolean (ja of nee) terug. Een positief label betekent dat de rechter het vereiste inhoudelijk behandelt, ongeacht of eraan is voldaan. Met deze labels kon het zoeken naar jurisprudentie zich vervolgens richten op uitspraken die relevant zijn voor een specifieke rechtsvraag.
Ik vergeleek GPT-5.4 en Mistral Medium 3.5 met een handmatig geannoteerde steekproef van 100 uitspraken. De resultaten laten een interessante afweging zien:
| Model | Precisie | Recall | F1-score |
|---|---|---|---|
| GPT-5.4 | 93% | 88% | 91% |
| Mistral Medium 3.5 | 80% | 94% | 86% |
Tabel 1. Prestaties bij het annoteren van de vereisten, vergeleken met 100 handmatig geannoteerde uitspraken.
Precisie betreft het aandeel toegekende positieve labels dat juist was. Recall betreft het aandeel werkelijk positieve gevallen dat het model wist te vinden. GPT leverde minder vals-positieve labels op; Mistral miste minder uitspraken die relevant waren. Voor het zoeken naar relevante uitspraken koos ik Mistral vanwege de hogere recall: voor een jurist kan het vervelender zijn om een relevante uitspraak te missen dan om een irrelevante uitspraak te moeten scannen. Bovendien is Mistral Medium 3.5 een open-weight model. Dat betekent dat het bij verschillende AI-providers kan worden gedraaid, wat de reproduceerbaarheid ten goede komt.
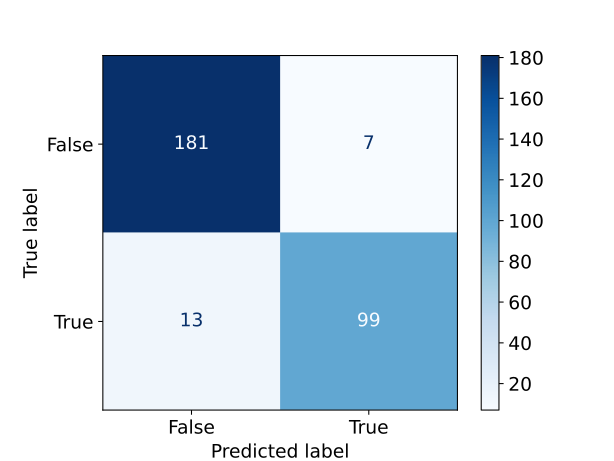
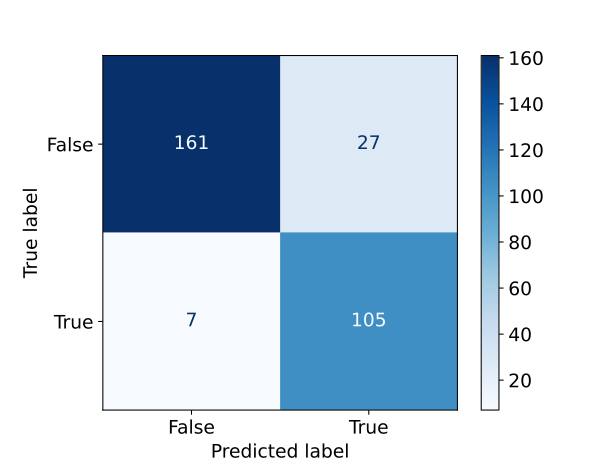
Deze resultaten ondersteunen een specifieke toepassing van annotatie binnen een onderzoeksproces. Het toont ook aan waarom de keuze van een model om meer draait dan één totaalscore: welke fouten het zwaarst wegen, hangt af van wat je vervolgens met de resultaten doet.
Sectoren toevoegen aan een klantendatabase
Een vergelijkbaar probleem deed zich voor tijdens een CRM-migratie voor mijn opdrachtgever, een mkb-bedrijf in metalen dak- en gevelsystemen. De opdrachtgever wilde de zakelijke contacten indelen naar sector, aan de hand van categorieën die we samen hadden afgestemd. De bestaande data bevatten vaak te weinig informatie om dit betrouwbaar te kunnen doen.
Daarom vulde ik de CRM-data aan met de inhoud van websites. Met Crawl4AI, een open-source webcrawler, haalde ik de tekst van bedrijfswebsites op. Daarvoor gebruikte ik het websiteveld in het CRM of de domeinnaam van het zakelijke e-mailadres. Het AI-model kreeg vervolgens de bedrijfsgegevens, de opgehaalde websitetekst en de instructies voor de classificatie. Die instructies hielden ook rekening met een minder vanzelfsprekend probleem: het e-maildomein van een contactpersoon kan bij een andere organisatie horen. Het model diende daarom eerst te beoordelen welke website bij het bedrijf hoorde, voordat de inhoud daarvan kon worden gebruikt.
Omdat het klantdata van mijn opdrachtgever betrof, gebruikte ik Mistral Medium 3.5 via de Franse cloudprovider Scaleway: de data bleven binnen de Europese Unie en werden niet gebruikt om nieuwe modellen te trainen. Het LLM kreeg de opdracht om ieder bedrijf aan één sector uit de vooraf opgestelde lijst toe te wijzen, met een toelichting in één zin. De resulterende dataset omvatte bijna 2.100 bedrijven.
In plaats van het model te vragen hoe zeker het was van de classificatie (LLM’s kunnen hun eigen zekerheid slecht beoordelen), leidde ik een score af uit de kansen die het model toekent aan ieder woordfragment (token) dat het genereert. Ik combineerde de kansen van de tokens waaruit het gekozen sectorlabel bestond. Het model genereerde eerst een korte toelichting, zodat de kansen mede afhankelijk waren van die toelichting.
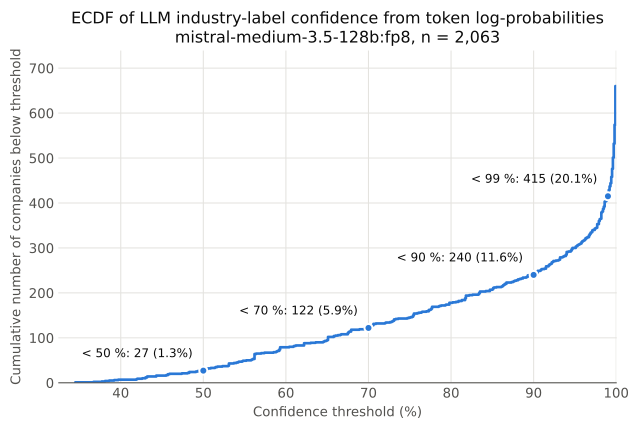
Deze scores gaven een indicatie van onzekerheid, geen garantie dat de indeling juist was. Ik gebruikte ze om de volgorde van de handmatige controle te bepalen, te beginnen bij de laagste scores. Een medewerker controleerde een deel van de classificaties en paste ze waar nodig aan.
De praktische winst was een database die het mogelijk maakt om te rapporteren op basis van sectoren van klanten. Informatie die eerder verspreid stond over verschillende records en websites, werd zo bruikbaar voor het analyseren van klantgroepen en het onderbouwen van commerciële beslissingen. De waarde ligt besloten in wat die aanvullende velden mogelijk maken.
Verkoopleads van bruikbare titels voorzien
Dezelfde CRM-migratie leverde een kleinere, maar herkenbare uitdaging op. Bij veel verkoopleads ontbrak een korte, beschrijvende titel, terwijl het nieuwe systeem die wel vereiste. De relevante informatie stond vaak al in klantvragen, interne notities en e-mails.
Ik gebruikte die informatie om korte Nederlandse titels te genereren, doorgaans van hooguit acht woorden, die het onderwerp beschreven en het bedrijf of de persoon benoemden. Als er weinig informatie beschikbaar was, kon het model terugvallen op de bron en de naam van de lead.
Naar mijn ervaring waren de resultaten in de meeste gevallen bruikbaar. Het verwerken van ruim 2.700 leads kostte minder dan €4 aan AI-modelverbruik, exclusief de tijd voor development en beoordeling. Strikt genomen is het genereren van titels een korte samenvattingstaak. Daarmee gaat deze toepassing van dezelfde aanpak voor dataverrijking een stap verder dan het toekennen van vooraf bepaalde categorieën.
De infrastructuur en het model kiezen
Voor de beschreven toepassingen bij mijn opdrachtgever gebruikte ik Mistral via de Franse cloudprovider Scaleway. Deze dienst draait op Europese infrastructuur en gebruikt klantdata niet om de onderliggende modellen te trainen. Ingevoerde prompts en modelantwoorden worden standaard niet bewaard, met beperkte uitzonderingen voor het oplossen van technische problemen en voor beveiliging (Scaleway, 2025).
Ook de keuze van het model kun je afstemmen op de taak. Een classifier deelt invoer in bij een van de vooraf bepaalde categorieën (Jurafsky & Martin, 2026, § 4.1). Ondanks dat algemene LLM’s dat ook kunnen, bieden gespecialiseerde modellen wellicht een efficiëntere aanpak als je alleen een boolean (ja of nee) of een sectorlabel nodig hebt.
Een recent voorbeeld is Jev van TypeSafe, geïntroduceerd in september 2026. Dit model geeft vooraf gedefinieerde waarden van een vastgelegd datatype terug, met bijbehorende kansen. De ontwikkelaar rapporteert aanzienlijke voordelen in snelheid en kosten ten opzichte van algemene LLM’s (Almeida, 2026).
Laya biedt een open-weight aanpak voor vergelijkbare taken, waardoor het model kan draaien op infrastructuur die de gebruiker zelf kiest (Convai Innovations, z.d.). Voor beide benaderingen is de praktische vraag hoeveel efficiënter deze kunnen zijn, met behoud van voldoende nauwkeurigheid voor de beoogde taak.
Conclusie
In het publieke debat over AI wordt automatisering met generatieve AI soms neergezet als iets beangstigends. Deze voorbeelden geven mij juist reden om optimistisch te zijn over het gebruik van AI voor data-annotatie. Menselijke inspanning blijft nodig om categorieën vast te stellen, onduidelijkheden te verhelpen en de resultaten te beoordelen. Als die basis eenmaal staat, kan AI het werk haalbaar maken op een schaal die anders moeilijk te verantwoorden zou zijn.
Nu AI verschuift van vaste abonnementen naar een prijs per token, gaan kosten een grotere rol spelen. Daar ligt misschien wel de belangrijkste les: het loont om na te gaan welk model voldoende nauwkeurigheid biedt tegen aanvaardbare kosten voor de beoogde taak. Voor de hierboven beschreven toepassingen bleken de eisen aan het model eenvoudiger dan je op het eerste gezicht zou verwachten.
Om die keuze te maken, moet je weten hoe een bruikbaar resultaat eruitziet. De sterkste resultaten beginnen met een goed omschreven vraag, geschikt bronmateriaal en een duidelijk beeld van welke fouten aanvaardbaar zijn.
Een database vol communicatie bevat al een hoop kennis. Soms is de meest nuttige bijdrage van AI om die kennis in een veld te verwerken waar je daadwerkelijk iets mee kan.